
特別寄稿
音声レート1kbps以下! ニューラル音声コーデックSNACとGNU Radioで狭帯域デジタル無線モデムを作ってみた
2026年11月16日掲載
無線の周波数資源は貴重です。同じ帯域の中でより多くの通信を行うため、これまでチャネル間隔の狭帯域化が進められてきました。
アナログFMでは、最大周波数偏移を小さくすることで占有帯域幅を抑えてきました。しかし、偏移を小さくするほど、復調後のS/Nとの両立が難しくなります。12.5kHz、さらに6.25kHzと狭いチャネル間隔で音声を伝えるために、音声を圧縮してデジタル信号として送る方式が広まってきました。
そこで重要になるのが、音声を少ないビット数に変換するボコーダーです。デジタル化した音声波形をそのまま送る代わりに、声の特徴を少ない情報で表し、受信側で音声を再構成します。
D-STARのDVモードではDVSI社のAMBE+TM(1999年)を採用し、音声2,400bit/sに誤り訂正用の1,200bit/sを加え、音声に関する部分を合計3,600bit/sで送ります。一方、デジタル簡易無線などで使われるAMBE+2TM(2005年)は、音声2,450bit/sと誤り訂正用1,150bit/sで、こちらも合計3,600bit/sです。
また、アイコムは2018年に独自の音声符号化方式TOKUDERⓇを開発し、デジタル小電力コミュニティ無線機IC-DRC1に搭載しました。TOKUDERⓇの音声レートは2400bpsです。
ニューラル音声コーデックとの出会い
公開された音声コーデックとしては、2012年にIETF(Internet Engineering Task Force)で標準化されたOpusがよく知られています。固定ビットレートにも対応しますが、対応するビットレートは6kbpsからです。
2022年には、Meta社がEnCodecを発表しました。ニューラルネットワークで音声や音楽を圧縮する方式で、24kHzのモノラルモデルでは1.5kbpsも選べます。音楽でも使えるように最適化されているためか、筆者が試聴した低ビットレートのサンプルでは、音声の再現は今一つの印象でした。
そして2024年、Hubert Siuzdak氏、Florian Grötschla氏、Luca A. Lanzendörfer氏によるニューラル音声コーデックSNACが発表されました。音声向けの24kHzモデルは、驚きの1kbps以下、約0.98kbps(984.375bit/s)です。公式の音声サンプルを聴き、「このビットレートで、ここまで声が伝わるのか」と驚きました。
以下のサイトで聴き比べられます。
https://hubertsiuzdak.github.io/snac/
SNACは何を送っているのか
SNACの処理は、大まかには次のようになります。
音声波形 → ニューラルエンコーダー → 量子化された番号列 → ニューラルデコーダー → 復元音声
エンコーダーは、学習済みのニューラルネットワークで音声から特徴を取り出します。その特徴を、コードブックという「特徴ベクトルの辞書」に登録された候補で近似し、対応する番号を送ります。この番号をtokenと呼びます。受信側では、番号から特徴を取り戻し、デコーダーで音声波形を再構成します。今回使う24kHzモデルでは、2,048サンプル、約85.3msの音声を単位にすると、合計7個のtokenを得ます。各tokenの値は0~4,095なので、1個を12bitで表せます。したがって、約85.3msの音声が7個×12bit=84bitになります。
7個 × 12bit ÷ (2,048 ÷ 24,000秒) = 984.375bit/s
これが音声ペイロードの定常的な速度です。
D-STARの音声部分2,400bit/sと比べると、約41%、約2.44分の1です。音声圧縮部分だけを見れば、従来の約4割のデータ量で声を表せる計算です。
一方、送るデータが小さいからといって、処理も小さいわけではありません。モデルは約1,980万パラメータを持ち、重みを32bit浮動小数点で保持すると、単純計算で約79MBです。実行時には中間データなどのメモリも必要です。従来の小規模なDSP構成に、そのまま置き換えるのは難しそうです。実際に無線機へ組み込むなら、モデルの量子化や演算の最適化に加え、NPU搭載SoCなどが候補になるでしょう。
GNU Radioのブロックを作ってみる
まず、GNU Radioで使えるSNAC EncoderとDecoderブロックを作りました。Encoderは24kHzのモノラル音声を受け取り、tokenをメッセージとして出力します。Decoderは、そのtokenを受け取って音声ストリームに戻します。
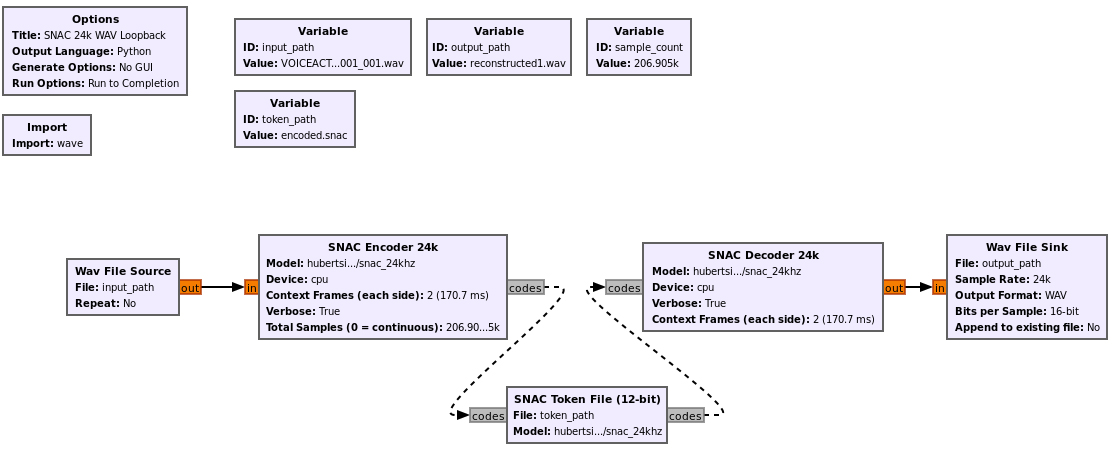
図: GNU Radio上に作成したSNACのエンコーダー/デコーダーブロック
最初はフレームごとに独立に圧縮・復号し、出力をつなぎ合わせました。すると、境界で「プツプツ」という不連続音が聞こえました。前後の音声が途切れることで、モデルの端の処理が影響していると考え、処理区間の前後にも音声を加えて、中央の必要な部分だけを取り出す方式に変更しました。
前後1フレームと前後2フレームを比較したところ、今回の2本の試験音声では、前後2フレームの条件で全3階層の番号列が全体一括処理と一致しました。前後1フレームでは完全には一致しませんでしたが、十分に自然な音声のように感じられます。
音声データはJVS(Japanese versatile speech) corpusを使用しました。
〈試聴(男性): 原音/前後フレームなし/前後1フレーム/前後2フレーム〉
〈試聴(女性): 原音/前後フレームなし/前後1フレーム/前後2フレーム〉
今回の試験環境(Intel Core i7-8565U、Windows 11、WSL 2)では、1フレームの復号処理時間が音声長の85.3msを超える場面もありました。実時間で会話するには、推論処理の最適化や実行環境の検討が必要です。
無線フレームを作る
音声の84bitを、そのまま変調器へ入れるだけでは、同期や伝送誤りへの対策が足りません。そこで、誤り訂正、インターリーブ、ホワイトニングなどを追加し、狭帯域デジタル無線を模したフレームを作りました。
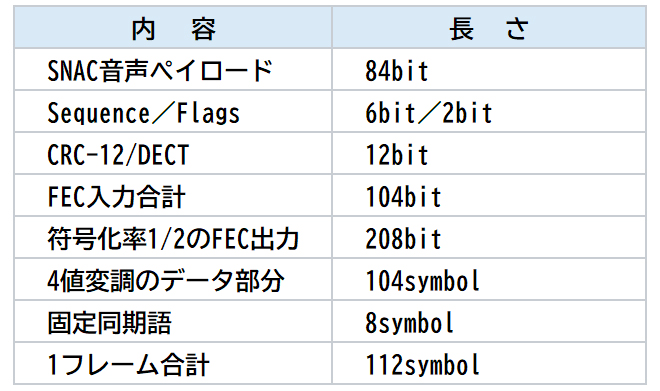
約85.3msごとに112symbolを送るので、必要なシンボルレートは1,312.5symbol/sです。6.25kHzチャネル間隔の4値FSK方式で使われる2,400symbol/s、4,800bit/sと比較すると、今回の1,312.5symbol/sは約55%、約1.83分の1です。
D-STARのDVモードも総伝送速度は4,800bit/sですが、変調はGMSKで、シンボルレートは4,800symbol/sです。今回とのシンボルレート比は約27%になるものの、変調方式が違うため、その比率だけで帯域幅の縮小率を判断することはできません。
次ページは「変調器の設計」から
NEWS
連載記事
PHONEで楽しむQRP通信
第41回 デビュー45周年を迎えたミズホピコトランシーバーを振り返る
Summits On The Air (SOTA)の楽しみ
その109 登山にチャレンジ-8
アパマンハムのムセンと車
第50回 モービル&アパマン運用に役立つヒント
新・エレクトロニクス工作室
第54回 ミニリニアの作製
MasacoのFBチャレンジ!
<交信局数>新記録に挑戦! ~達成するまで帰れません?~
Masacoのログブック
October 16~30 2026
特別寄稿
音声レート1kbps以下! ニューラル音声コーデックSNACとGNU Radioで狭帯域デジタル無線モデムを作ってみた
頭の体操 詰将棋
2026年11月の出題
コンテストインフォメーション
2026年11月に開催予定のコンテストについて
日本全国・移動運用記
第134回 長崎県島原地方・熊本県天草地方移動
おきらくゴク楽自己くんれん
その65 シャック外装問題とソーラーパネル発電テスト
アマチュア無線の今と昔
第48回 浦島太郎になって迷っているカムバック組の皆様へ
今更聞けない無線と回路設計の話
【テーマ2】デシベルと無線工学 (第25話)
特別寄稿
アンテナ解析ソフトMMANAを使ってHB9CVアンテナを設計してみる【後編】
Masacoのむせんのせかい
第80回 神奈川県立海洋科学高等学校 電子研究サークル(JA1ZNW)の皆さん
Masacoのログブック
October 1~15 2026
外部リンク
アマチュア無線関連機関/団体
各総合通信局/総合通信事務所
アマチュア無線機器メーカー(JAIA会員)
